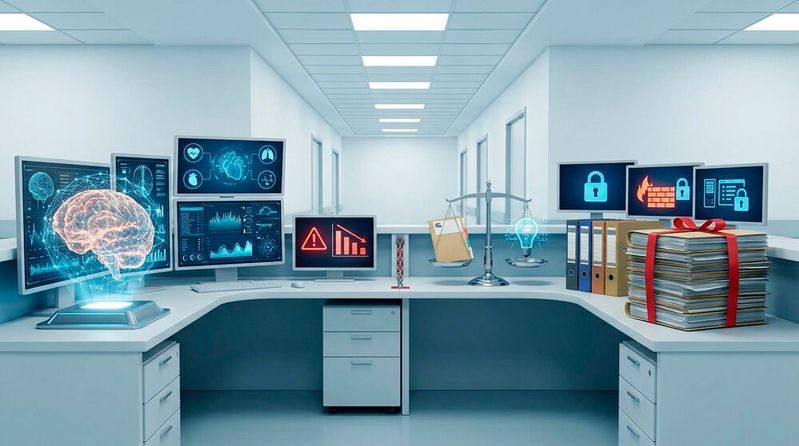
Akteure im Gesundheitswesen arbeiten unter widersprüchlichen Bedingungen. Während die Erwartungen an KI-gestützte Versorgungspfade, moderne Assistenzsysteme und eine stärkere Vernetzung steigen und der Fachkräftemangel den Handlungsdruck erhöht, werden die regulatorischen Anforderungen an Dokumentation und Informationssicherheit strenger.
Arbeiten im Spannungsfeld zwischen Anforderung und Erwartung.
(Bild: Gemini / KI-generiert)
Aus diesem Spannungsfeld entsteht der grundlegende Zielkonflikt zwischen Compliance und Datenzugriff. Im Kern geht es dabei um zwei entscheidende Fragen: Wie schnell erreichen valide Daten autorisierte Personen und Systeme, und wie belastbar lässt sich dieser Weg dokumentieren?
Befeuert wird diese Dynamik von der Politik, denn das Bundesministerium für Gesundheit treibt mit seiner Digitalisierungsstrategie und dem Krankenhauszukunftsgesetz (KHZG) die Vernetzung des Gesundheitswesens voran. Dadurch müssen große Mengen medizinisch relevanter und teils lebensentscheidender Informationen sicher und bedarfsgerecht verfügbar sein. Zentrale Datenplattformen allein klären dabei jedoch noch nicht, wie diese kontrolliert bei den Fachanwendenden ankommen, sodass ein echtzeitnaher Zugang zu validen Daten letztlich unerlässlich bleibt.
Am deutlichsten zeigt sich das in drei Feldern, die zwar unterschiedliche Anforderungen stellen, im Kern aber alle auf dasselbe Problem zurückzuführen sind:
Die klinische Forschung ist darauf angewiesen, Bestände aus Labor, Bildgebung und Genomik gemeinsam auszuwerten.
Die Patientenversorgung muss Systemlandschaften so zusammenführen, dass interdisziplinäre Teams rasch belastbare Entscheidungsgrundlagen erhalten.
Betreiber von Krankenhausinformationssystemen (KIS), Versorgungsnetzwerke sowie Kostenträger müssen selbst dann auskunftsfähig bleiben, wenn einzelne Subsysteme ausfallen.
Was Vertrauenswürdigkeit im regulierten Gesundheitsbereich bedeutet
Was in der klinischen Forschung, der Patientenversorgung und im Systembetrieb jeweils gebraucht wird, läuft am Ende auf denselben Begriff hinaus: vertrauenswürdige Daten. Im Gesundheitswesen bedeutet das jedoch mehr als im klassischen IT-Verständnis, wo ein Datensatz bereits dann als vertrauenswürdig gilt, wenn er aktuell und fachlich richtig ist. Hinzu kommen hier streng kontrollierte Zugriffsrechte, die Wahrung des Patientengeheimnisses und offene Interoperabilitätsstandards wie FHIR.
Den rechtlichen Rahmen setzen dabei die DSGVO für besondere Kategorien personenbezogener Daten sowie die Europäische KI-Verordnung für Hochrisiko-Systeme im Medizinbereich – beide mit Kurs auf einen durchgängigen Datenlebenszyklus mit vollständiger Transparenz hinsichtlich Berechtigungen und Datenherkunft.
Warum zentrale Datenplattformen den Engpass nur verschieben
Die geforderte Transparenz über Berechtigungen und Datenherkunft scheitert in der Praxis selten an der Basisinfrastruktur. Zahlreiche Krankenhausverbünde haben längst in Data Lakehouses investiert und dort Bestände aus Krankenhausinformationssystemen (KIS), Bildgebung (PACS) und Laborsystemen (LIS) zusammengeführt. Die eigentliche Herausforderung beginnt erst danach, wenn diese Daten für Ärztinnen und Ärzte, Pflegende oder Controller nutzbar gemacht werden müssen.
An dieser Stelle greift ein etabliertes, aber problematisches Muster. Einzelne Auswertungswerkzeuge ziehen Daten aus der zentralen Plattform und liefern sie mit eigener Logik, eigenen Filtern und eigener Aktualisierungsfrequenz an die jeweiligen Zielsysteme. So entstehen aus einer Quelle viele abgeleitete Bestände und physische Kopien, für die im Hinblick auf das Patientendaten-Schutzgesetz (PDSG) Fragen zu Zugriffsschutz, Aufbewahrungsfrist und Anonymisierung zu beantworten sind.
Hinzu kommt der zeitliche Effekt. Extract-Transform-Load-Prozesse müssen aufwendig programmiert und getestet werden, zusätzliche Freigabeschritte verzögern neue Analysen, und Fachbereiche weichen dann mitunter auf Schatten-IT oder händische Exporte aus. Gefragt ist stattdessen ein übergreifender Mechanismus, der relevante Informationen aufbereitet bereitstellt, ohne für jeden Anwendungsfall neue physische Kopien zu erzeugen.
Die logische Datenschicht als Zugriffsmodell
Ein logisches Datenmanagement führt eine Schicht zwischen den Quellsystemen und den auswertenden Anwendungen ein und entkoppelt den Zugriff auf Daten von deren physischem Speicherort. Anwendungen rufen fertig definierte Sichten auf, etwa die Behandlungshistorie eines Patienten, ohne dass der Ursprungsbestand dupliziert werden muss.
Die Schicht ermittelt die passenden Quellen, greift nur auf benötigte Felder zu und verlagert aufwendige Berechnungen in das System, das sie am schnellsten ausführt. Der Bestand selbst bleibt dabei durchgehend im quellvalidierten Primärsystem. Technisch beruht dieser Ansatz auf dem Prinzip der Datenvirtualisierung, das sich in vier zentrale Bausteine gliedert: Die semantische Schicht übersetzt technische Feldbezeichnungen in die medizinische Fachsprache und nutzt Terminologieserver, etwa auf Basis von SNOMED CT oder ICD-10-GM. Datenprodukte bilden fest definierte Zusammenstellungen von Daten für einen bestimmten fachlichen Zweck, etwa ein Dashboard für OP-Kapazitäten oder die Erfassung von Behandlungspfaden. Der Datenmarktplatz beschreibt als zentraler Katalog, welche Datenquellen existieren, woher sie stammen und wer sie verantwortet. Schließlich ermöglicht die zentrale Governance die Durchsetzung von Zugriffsregeln, Anonymisierungen und Pseudonymisierungen für alle zugreifenden Anwendungen einheitlich direkt in dieser Schicht.
Stand: 08.12.2025
Es ist für uns eine Selbstverständlichkeit, dass wir verantwortungsvoll mit Ihren personenbezogenen Daten umgehen. Sofern wir personenbezogene Daten von Ihnen erheben, verarbeiten wir diese unter Beachtung der geltenden Datenschutzvorschriften. Detaillierte Informationen finden Sie in unserer Datenschutzerklärung.
Einwilligung in die Verwendung von Daten zu Werbezwecken
Ich bin damit einverstanden, dass die Vogel Communications Group GmbH & Co. KG, Max-Planckstr. 7-9, 97082 Würzburg einschließlich aller mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen (im weiteren: Vogel Communications Group) meine E-Mail-Adresse für die Zusendung von redaktionellen Newslettern nutzt. Auflistungen der jeweils zugehörigen Unternehmen können hier abgerufen werden.
Der Newsletterinhalt erstreckt sich dabei auf Produkte und Dienstleistungen aller zuvor genannten Unternehmen, darunter beispielsweise Fachzeitschriften und Fachbücher, Veranstaltungen und Messen sowie veranstaltungsbezogene Produkte und Dienstleistungen, Print- und Digital-Mediaangebote und Services wie weitere (redaktionelle) Newsletter, Gewinnspiele, Lead-Kampagnen, Marktforschung im Online- und Offline-Bereich, fachspezifische Webportale und E-Learning-Angebote. Wenn auch meine persönliche Telefonnummer erhoben wurde, darf diese für die Unterbreitung von Angeboten der vorgenannten Produkte und Dienstleistungen der vorgenannten Unternehmen und Marktforschung genutzt werden.
Meine Einwilligung umfasst zudem die Verarbeitung meiner E-Mail-Adresse und Telefonnummer für den Datenabgleich zu Marketingzwecken mit ausgewählten Werbepartnern wie z.B. LinkedIN, Google und Meta. Hierfür darf die Vogel Communications Group die genannten Daten gehasht an Werbepartner übermitteln, die diese Daten dann nutzen, um feststellen zu können, ob ich ebenfalls Mitglied auf den besagten Werbepartnerportalen bin. Die Vogel Communications Group nutzt diese Funktion zu Zwecken des Retargeting (Upselling, Crossselling und Kundenbindung), der Generierung von sog. Lookalike Audiences zur Neukundengewinnung und als Ausschlussgrundlage für laufende Werbekampagnen. Weitere Informationen kann ich dem Abschnitt „Datenabgleich zu Marketingzwecken“ in der Datenschutzerklärung entnehmen.
Falls ich im Internet auf Portalen der Vogel Communications Group einschließlich deren mit ihr im Sinne der §§ 15 ff. AktG verbundenen Unternehmen geschützte Inhalte abrufe, muss ich mich mit weiteren Daten für den Zugang zu diesen Inhalten registrieren. Im Gegenzug für diesen gebührenlosen Zugang zu redaktionellen Inhalten dürfen meine Daten im Sinne dieser Einwilligung für die hier genannten Zwecke verwendet werden. Dies gilt nicht für den Datenabgleich zu Marketingzwecken.
Recht auf Widerruf
Mir ist bewusst, dass ich diese Einwilligung jederzeit für die Zukunft widerrufen kann. Durch meinen Widerruf wird die Rechtmäßigkeit der aufgrund meiner Einwilligung bis zum Widerruf erfolgten Verarbeitung nicht berührt. Um meinen Widerruf zu erklären, kann ich als eine Möglichkeit das unter https://contact.vogel.de abrufbare Kontaktformular nutzen. Sofern ich einzelne von mir abonnierte Newsletter nicht mehr erhalten möchte, kann ich darüber hinaus auch den am Ende eines Newsletters eingebundenen Abmeldelink anklicken. Weitere Informationen zu meinem Widerrufsrecht und dessen Ausübung sowie zu den Folgen meines Widerrufs finde ich in der Datenschutzerklärung, Abschnitt Redaktionelle Newsletter.
Der regulatorische Nutzen liegt auf der Hand. Daten, die nicht physikalisch kopiert werden, müssen auch nicht als Kopie verwaltet, geschützt und gelöscht werden. Zugleich bleibt für jeden Wert transparent nachvollziehbar, aus welchem Quellsystem er stammt. Der Ansatz ersetzt weder die zentrale Datenplattform noch das Archiv für langfristig aufzubewahrende Bestände, sondern ordnet den Zugriff auf beide.
Einsatzfelder in der klinischen Praxis und Forschung
In der klinischen Versorgung und Forschung müssen heterogene Datenmengen gemeinsam ausgewertet werden. Ein logischer Zugriff kann verteilt liegende Patientendaten, Laborwerte und Bildgebungsmetadaten für definierte Fragestellungen zusammenführen, ohne dauerhafte Datensilos aufzubauen, und senkt so den Entwicklungsaufwand für neue IT-Schnittstellen erheblich.
Dass dieses Prinzip in der Praxis funktioniert, zeigt das Beispiel von Fresenius Medical Care. Der Dialyseanbieter integrierte über die Plattform von Denodo sein SAP-Datawarehouse mit zahlreichen Nicht-SAP-Quellen in einer semantischen Schicht und ersetzte damit eine aufwendige Middleware-Anbindung. Analysten, Data Scientists und Anwendungen erhalten dadurch durchgängigen, konsistenten Zugriff auf verteilte Daten für schnellere, fundierte Entscheidungen. Zusätzlich lassen sich Altsysteme über harmonisierte Webservices einbinden und bestehende Datensilos abbauen, während sich die Data Governance zentralisiert und der Datenkatalog transparenter wird – ein entscheidender Vorteil im Umgang mit sensiblen Patientendaten.
Auch für gesetzliche Berichterstattungspflichten, etwa zur Qualitätssicherung nach SGB V, bietet dieses Prinzip Vorteile. Sind Datenquellen und Transformationsregeln in kontrollierten Datenprodukten hinterlegt, lässt sich die Bereitstellung standardisieren und wiederverwenden.
IT-Sicherheit und Verantwortlichkeit
So hilfreich diese Standardisierung für Berichtspflichten ist, sie befreit nicht von einer eigenen Prüfpflicht für die Zugriffsschicht selbst. Der § 391 SGB V verpflichtet inzwischen alle Krankenhäuser zu angemessenen technischen und organisatorischen Vorkehrungen nach dem Stand der Technik für Verfügbarkeit, Integrität und Vertraulichkeit ihrer IT-Systeme, orientiert am BSI-anerkannten Standard B3S Krankenhaus.
Diese Vorgaben betreffen ausdrücklich auch die Schicht, über die Fachanwendende auf Daten zugreifen, denn ein Sicherheitsvorfall lässt sich dort ebenso wenig ausschließen wie in den Quellsystemen selbst. Eine zentrale Zugriffsschicht erleichtert den entsprechenden Nachweis, weil sich Zugriffsregeln und Protokollierung an einer Stelle bündeln lassen, statt in jedem einzelnen Zielsystem separat gepflegt werden zu müssen. Sie ersetzt jedoch nicht die Festlegung, wer für ein Datenprodukt inhaltlich verantwortlich ist, es regelmäßig prüft und im Ernstfall nachweislich Rechenschaft ablegen muss.
Künstliche Intelligenz als nächste Stufe der Datenverarbeitung
Diese Frage nach Verantwortlichkeit gewinnt zusätzliches Gewicht, sobald nicht mehr nur Menschen, sondern auch KI-Systeme auf die Daten zugreifen. Der Einsatz generativer Verfahren und maschineller Lernmodelle verspricht im Gesundheitswesen erhebliche Effizienzgewinne, etwa bei der Arztbrieferstellung oder der Diagnoseunterstützung. Dieser Nutzen hängt jedoch vollständig von der Datenqualität ab, denn Sprachmodelle, die mit veralteten oder unvollständigen Beständen arbeiten müssen, können im klinischen Kontext gefährlich fehlerhafte Ergebnisse liefern. Der seit August 2026 geltende EU AI Act unterwirft KI-Systeme in der Medizin daher strengen Governance-Pflichten, weshalb auch sie ihre Daten über dieselbe kontrollierte Zugriffsschicht beziehen sollten wie andere Anwendungen, damit Zugriffsrechte, Pseudonymisierung und Audit-Protokolle einheitlich gelten.
Fazit
Die Entkopplung von Zugriff und Speicherort verringert die Zahl zusätzlicher Datenkopien und begrenzt den Compliance- und Kontrollaufwand im Gesundheitswesen erheblich. Datenschutzrechtliche Vorgaben an Quellsysteme und Datenflüsse bleiben davon unberührt, ihre Durchsetzung lässt sich dadurch jedoch an zentraler Stelle, statt über verstreute Kopien hinweg, bündeln.
Für Gesundheitseinrichtungen empfiehlt sich deshalb ein schrittweises Vorgehen. Ein erstes Datenprodukt mit hohem fachlichem Nutzen, etwa ein zentrales Belegungs- oder Qualitäts-Reporting, liefert erste Erfahrungswerte, bevor tiefergehende medizinische Primäranwendungen folgen. Wer den Zugriff auf Gesundheitsdaten als eigenständige, zentral kontrollierte Funktion begreift, kann die Bereitstellung beschleunigen, ohne Datenschutz, Datenintegrität und Patientensicherheit zu gefährden.
Der Autor
Jörg Hesske, Regional Vice President and General Manager for Central & Eastern Europe bei Denodo